从视觉辅助到内容适配,AI需要清晰的任务、可靠的数据与可持续的验证机制。本文围绕应用规划与技术选型展开,提供可以用于需求讨论的思路。不同项目的设备条件和验证方式存在差异,应结合实际资料进一步确认。
先明确问题,再选择模型
人工智能可以用于图像分析、内容分类、设备状态整理等任务,但同一个模型无法自动解决所有现场问题。部署前应写清输入、输出与错误后果:识别缺陷、判断画面类别和预测设备异常,对数据与系统的要求并不相同。
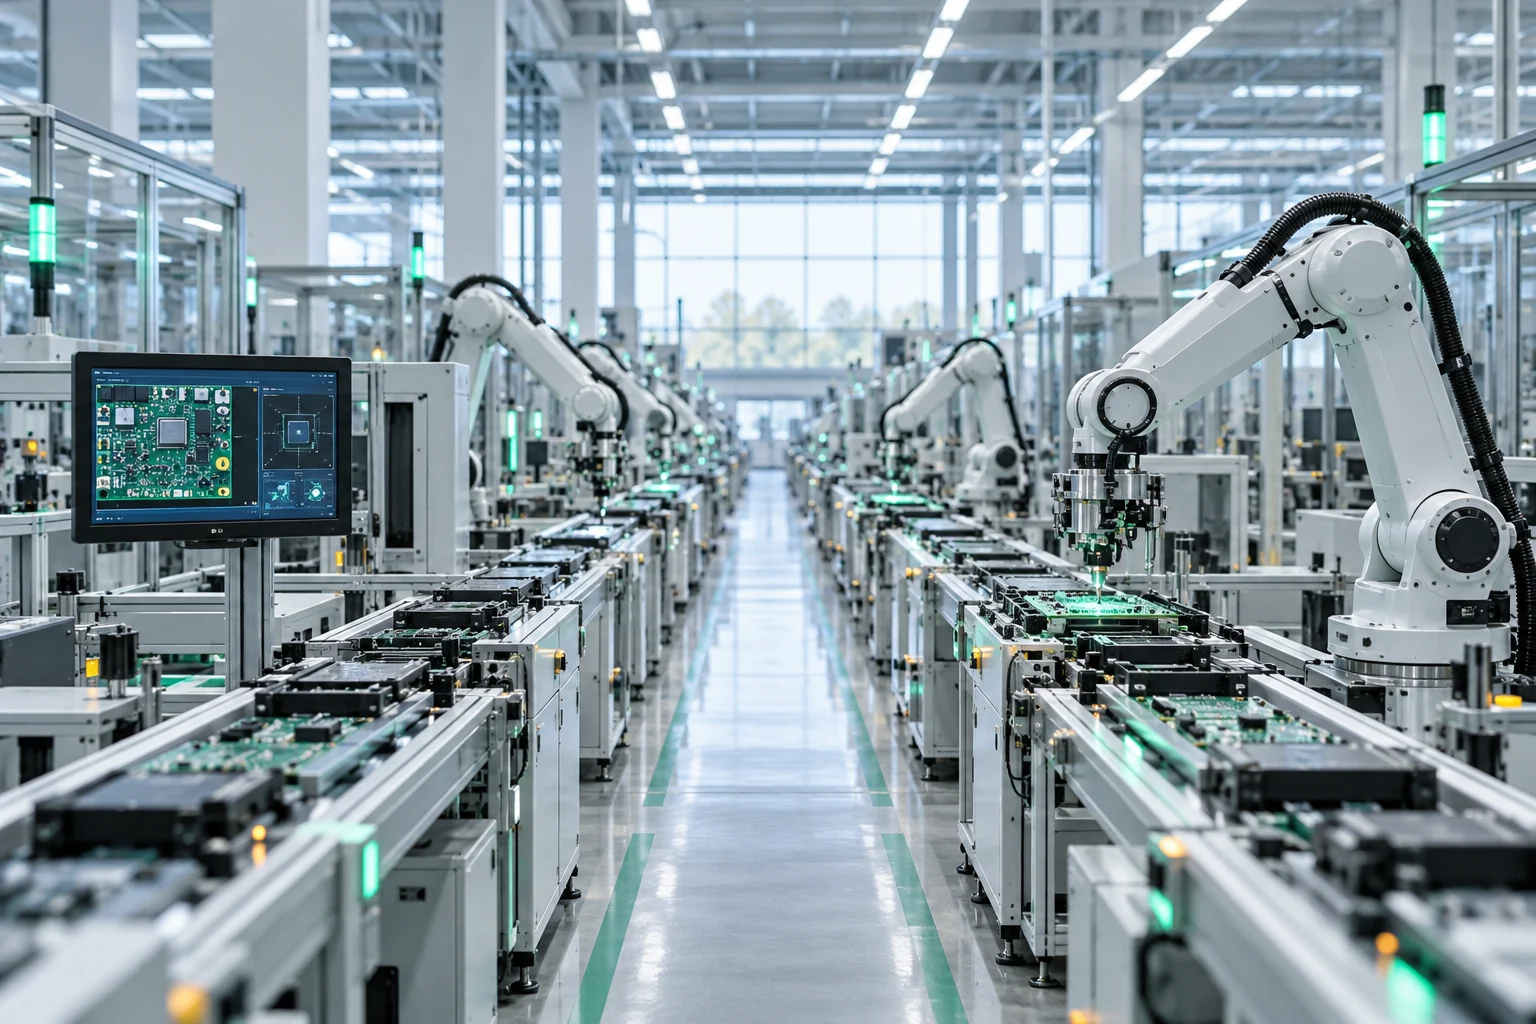
对于制造现场,更需要定义漏检和误报的成本,并安排复核流程。可展示的识别结果只是起点,真正的应用需要覆盖不同光照、设备状态和材料批次。
数据质量决定评估基础
训练数据与测试数据应合理分离,避免把模型已经见过的内容当作新场景验证。采集过程还要记录拍摄位置、光源、时间和标注规则,使结果差异可以被解释。
当现场条件改变,数据分布也可能变化。系统需要持续观察错误模式,保留样本复核和版本回退机制,而不是仅在首次上线时完成一次测试。
边缘计算与云端各有条件
在设备本地进行处理,可以减少传输并改善部分实时任务,但会受到计算资源、散热和维护方式限制。云端方案则需要考虑网络稳定性、数据访问范围和服务依赖。
选择架构时,应把延迟、成本、资料保护和更新机制放在同一张清单中比较。所谓边缘或云端,本身并不能代表一个方案必然更安全或更有效。
让模型输出融入人机流程
AI结果需要以用户能够理解的方式显示。置信信息、异常提示和待复核状态应区分清楚,关键动作也需要明确的责任边界。
J9九游会AI创新技术专题将模型、显示与现场流程放在一起讨论。实际项目可以从单一、可衡量的任务开始,在独立测试与人员反馈基础上决定是否扩大应用。
把模型指标与业务问题分别说明
模型评估可以关注准确率、召回、误报和延迟,但这些指标必须对应任务。一个误报很少的模型,也可能漏掉重要情况;一个识别速度快的系统,也可能在输入画面变化后出现偏差。因此不能用单个分数替代完整判断。
在界面上区分已确认、待复核和无法判断的结果,让使用者理解系统状态。对结果的处理、保存和追溯应形成独立流程,避免未经复核的输出直接触发关键动作。
试点应保留退出与回退条件
项目开始时可以先选择一个边界清楚的任务,让AI作为辅助信息与现有流程并行运行。记录错误类型、人工处理工作量和现场反馈,评估是否真的解决了原问题。
试点结束后,应明确哪些条件已经验证、哪些仍然未知,以及什么情况下需要停止自动处理。保留旧版本、配置和样本记录,比仅保存一个模型文件更利于维护。
阅读要点
从理解问题,到建立验证
先明确使用场景与需求边界,再比较产品与技术,最后在真实条件下检验结果。将数据来源、使用条件与维护方式一起记录,能够让不同方案之间的讨论更清晰。
内容说明:本文为技术与应用知识稿,页面日期为本稿发布标记,不代表企业活动、合作或项目交付公告。技术表现与具体要求应以正式产品资料和项目验证为准。